与 Neuron 集成
Neuron 是 EMQ 开发的工业物联网连接平台,支持 Modbus、OPC UA、BACnet 等多种工业协议。eKuiper 是开源的轻量级边缘流处理引擎,使用 SQL 处理数据,并通过输出动作(sink)转发。NeuronEX 是 EMQ 的工业边缘数据采集与处理软件,集成 Neuron 的协议采集和 eKuiper 的流处理能力,提供统一的 Web 界面配置设备采集、数据处理及转发。
本文介绍三种将 Neuron 采集数据写入 TDengine 的方式:
- 安装时接入:适用于尚未安装 NeuronEX 企业版的环境。执行安装命令时,自动完成 NeuronEX 安装、注册到 taosExplorer、创建
neuron业务数据库、neuron_demo示例数据库和四个示例设备,并配置写入链路,安装后无需在 taosExplorer 页面操作。 - 一键接入:适用于已部署 Neuron 或 NeuronEX 的环境。在 taosExplorer 的「数据写入 → 数据采集代理 → Neuron」页面填写 Neuron 地址和凭据,taosExplorer 自动完成数据流、处理规则和采集订阅的配置。
- 手工接入:适用于已部署 Neuron 或 NeuronEX、需要自定义标签、业务属性或数据转换的场景。在 NeuronEX 页面手工配置数据流、处理规则和 InfluxDB v1 写入动作。
| 方式 | Neuron 是否需预装 | 适用场景 | taosExplorer 操作 |
|---|---|---|---|
| 安装时接入 | 不需要 | 尚未安装 NeuronEX 企业版 | 不需要 |
| 一键接入 | 需要 | 已部署 Neuron 或 NeuronEX | 需要向导 |
| 手工接入 | 需要 | 已部署,需要自定义标签或转换 | 需要手工配置 |
三种方式的数据面完全相同:Neuron 将采集报告发给 eKuiper,eKuiper 提取测量列和标签,编码为 Influx 行协议并批量写入 TDengine,通过无模式写入自动创建超级表和子表。该方式可接入 Neuron 支持的 70 多种工业协议,具体以版本及授权为准。

Neuron 与 TDengine 集成架构
如上图所示,Neuron 将设备数据转为 JSON 采集报告,eKuiper 提取测量列和标签,编码为 Influx 行协议并批量写入 TDengine,通过无模式写入自动创建超级表和子表。需要双向 TLS 认证(mTLS)或高可用部署时,按后文加密传输与高可用配置。
前置条件
Neuron 和 eKuiper 的准备方式
尚未安装
- 使用 TDengine 企业版安装包提供的
apex工具。 - 无需预先安装 Neuron 或 eKuiper:安装过程会自动安装 NeuronEX(内置 eKuiper),并注册到 taosExplorer。
- 同机安装无需额外网络配置;跨机安装时,NeuronEX 所在主机需能访问 TDengine 的
6041(taosAdapter)和6060(taosExplorer),taosExplorer 需能访问 NeuronEX 的8085(管理端口)。 - 安装时自动创建业务数据库
neuron(--database)、示例数据库neuron_demo(--database-demo)、四个示例设备(采集组meters)和示例规则;安装后可直接在 taosExplorer 查看。接入真实设备时,继续在 NeuronEX 添加设备、采集组和点位。
已经安装
- 已部署 Neuron 和 eKuiper:可以是 NeuronEX 4.0.0 及以上版本(已集成两者,参见 NeuronEX 安装文档),也可以是开源组合的 Neuron 2.15.0 及以上版本与 eKuiper(须包含 InfluxDB v1 sink)。
- 已在 Neuron(或 NeuronEX)中完成设备采集配置:设备已添加、采集组已创建、点位已配置,设备处于运行中、已连接状态,且在「数据监控」中能看到点位值持续更新。设备使用的协议没有限制——Modbus、OPC UA、Siemens S7 等 Neuron 支持的协议均可。
- Neuron 所在主机能够访问 taosAdapter 的 HTTP 端口,默认为
6041。 - 已创建用于写入的数据库。一键接入不会自动创建数据库;手工接入示例中会创建示例数据库。
- 已安装并完成采集配置后,可选择「一键接入」或「手工接入」。
通用
- TDengine TSDB 3.4.3.6 及以上版本。
- 需要断链缓存与恢复补发时,需确认 eKuiper 已包含缓存与转发一节所述的错误重试修复。
安装时接入
安装时接入依赖的 apex 工具尚未发布,计划于 2026 年 11 月上旬发布,敬请期待。
本节适用于尚未安装 NeuronEX 企业版的环境。安装过程会自动创建业务数据库 neuron、示例数据库 neuron_demo、四个示例设备和采集组 meters,完成后可直接在 taosExplorer 查看对接效果,无需在 taosExplorer 页面创建接入。接入真实设备时,继续在 NeuronEX 添加设备、采集组和点位;设备命名和分组建议先参考数据映射与采集配置规范。
安装命令由 TDengine 企业版安装包提供的 apex 工具执行,无需单独安装 NeuronEX。
安装完成后,taosExplorer 默认每 5 分钟轮询一次 NeuronEX 的设备列表;发现新设备且该设备已配置点位后,会自动创建或更新接入规则,无需在 taosExplorer 页面操作。自动发现仅针对新增设备名;已有设备新增采集组或点位时,请在 taosExplorer 详情页点击「刷新配置」重新扫描。轮询间隔可通过 taosExplorer 环境变量 NEURON_POLL_INTERVAL_SECS 调整,默认 300 秒;设为 0 可关闭。
由 taosExplorer 创建的规则和订阅由 taosExplorer 管理。请勿在 eKuiper 中手动修改这些规则;刷新时会按当前映射重新同步并覆盖手动修改。请先在 Neuron 或 NeuronEX 中配置设备、采集组和点位,再点击「刷新配置」。
同机安装可不填写任何连接参数;跨机安装必须指定 TDengine 所在主机的地址。其他参数可参考跨机安装内容。
同机安装
TDengine 和 NeuronEX 部署在同一台主机时,执行下面命令:
sudo apex install all
安装过程会自动完成以下工作:
- 安装并启动 NeuronEX,默认 Web 端口为
8085; - 将 NeuronEX 注册到本机 taosExplorer;
- 创建业务数据库
neuron(--database,默认neuron),已存在时复用; - 创建示例数据库
neuron_demo(--database-demo,默认neuron_demo),已存在时复用; - 创建四个 Modbus 模拟设备
demo_meter01至demo_meter04,采集组均为meters,写入neuron_demo; - 配置 TDengine 写入参数,并生成带
location标签的示例规则; - 生成 NeuronEX 管理员密码,保存到
/var/lib/apex/neuronex-admin-password(仅 root 可读)。
安装完成后,NeuronEX 已与本机 TDengine 对接,无需再填写 Neuron 地址、数据库或接入配置。典型输出如下:
[apex] Installing TDengine All-in-One...
[apex] NeuronEX installed and started: http://127.0.0.1:8085
[apex] NeuronEX registered with taosExplorer: http://127.0.0.1:6060
[apex] Database neuron created.
[apex] Demo database neuron_demo created.
[apex] Demo devices created: demo_meter01, demo_meter02, demo_meter03, demo_meter04
[apex] NeuronEX admin password saved to /var/lib/apex/neuronex-admin-password
[apex] NeuronEX is connected to TDengine.
跨机安装
TDengine 在另一台主机时,在 NeuronEX 所在主机执行:
sudo apex install neuronex --tdengine-host 192.168.1.100
将 192.168.1.100 替换为目标 TDengine 的主机 IP 或域名。其余参数使用默认值;如需自定义 TDengine 用户名、密码或其他参数,参考下表在命令中追加:
| 参数 | 默认值 | 说明 |
|---|---|---|
--tdengine-host | 本机 | TDengine 主机 IP 或域名,跨机安装时必填 |
--tdengine-port | 6041 | taosAdapter REST 端口 |
--tdengine-user | root | TDengine 用户名,需有创建数据库和目标库写入权限 |
--tdengine-password | taosdata | TDengine 用户密码 |
--explorer-port | 6060 | taosExplorer 端口 |
--database | neuron | 业务数据库,不存在时自动创建 |
--database-demo | neuron_demo | 示例数据库,不存在时自动创建;四个示例设备写入此库 |
跨机安装同样会创建业务数据库 neuron、示例数据库 neuron_demo 和四个示例设备。安装完成后,NeuronEX 会自动注册到该 TDengine 的 taosExplorer,并完成写入链路配置。输出与同机安装类似,其中注册地址为 http://<TDengine_IP>:6060,TDengine 目标为 http://<TDengine_IP>:6041。如果 TDengine 已单独安装在同一台主机,可省略 --tdengine-host。
安装时自动生成 NeuronEX 管理员密码,保存在 /var/lib/apex/neuronex-admin-password。首次登录 NeuronEX 或添加真实设备时使用:
sudo cat /var/lib/apex/neuronex-admin-password
如需使用自定义密码,可在安装命令中追加 --neuron-password-file <path>。
在 taosExplorer 查看对接结果
同机安装和跨机安装都会在 taosExplorer 中自动创建接入记录,登录 taosExplorer,进入「数据写入 → 数据采集代理 → Neuron」,可以看到自动创建的 NeuronEX 接入记录。示例设备每秒写入数据,状态会自动变为「已验收」。在 neuron_demo 数据库中可以看到 meters 超级表,以及 demo_meter01 至 demo_meter04 四个子表,location 标签分别为 Factory01.Workshop01、Factory01.Workshop02、Factory02.Workshop01 和 Factory02.Workshop02。这里只用于查看,不需要创建接入或填写任何配置。
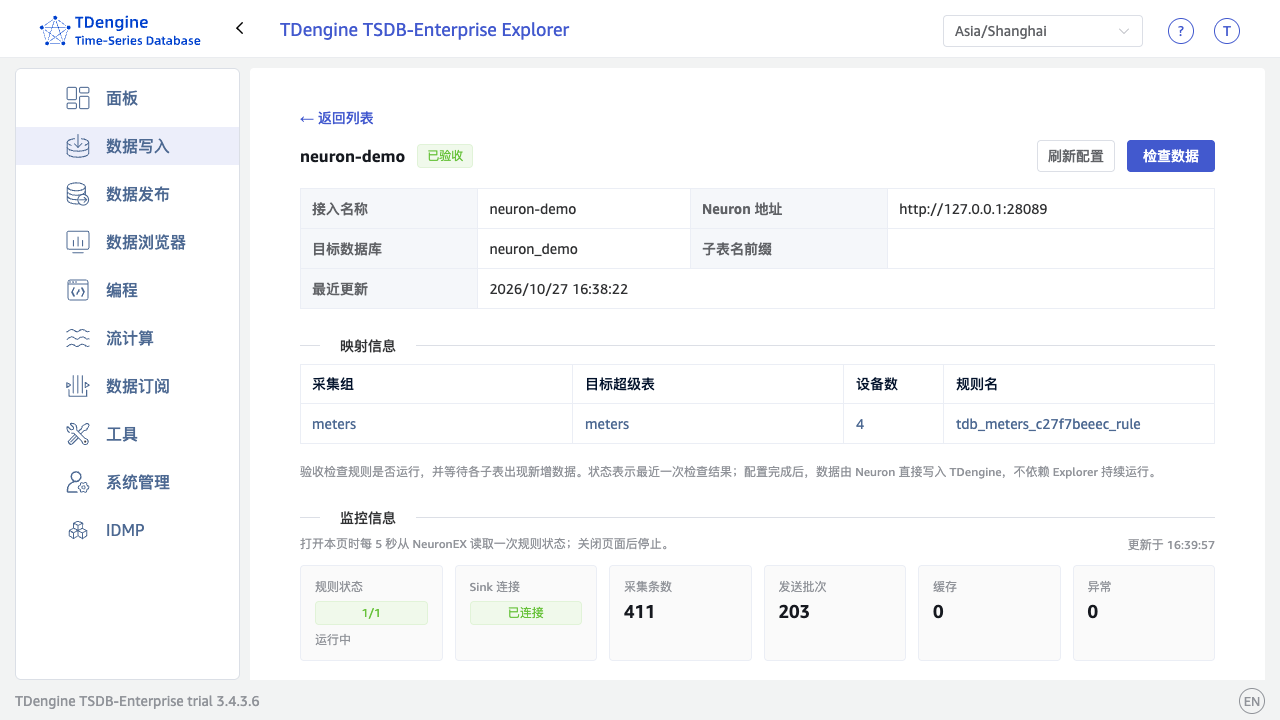
taosExplorer 中自动创建的 NeuronEX 接入
入库验证方法见后文验证结果。
一键接入
本节适用于已部署 Neuron 或 NeuronEX 的环境。全新安装 NeuronEX 时,推荐使用前文的「安装时接入」。
一键接入在 taosExplorer 中完成,无需在 NeuronEX 或 eKuiper 中手工创建数据流、规则或订阅;设备采集仍需提前配置。设备命名、对象映射和类型映射的通用规范见数据映射与采集配置规范。
1. 打开接入向导
登录 taosExplorer,在左侧导航选择「数据写入」,切换到「数据采集代理」页签,点击 Neuron 卡片。
2. 填写连接信息
上半部分为 Neuron 连接信息:
| 配置项 | 说明 |
|---|---|
| 接入名称 | 可选,用于列表与详情展示;留空时使用 Neuron 地址 |
| Neuron 地址 | Neuron 管理接口地址;NeuronEX 默认 8085,开源 Neuron 默认 7000,如 http://neuron-host:8085 |
| Neuron 用户名、密码 | Neuron 的登录凭据 |
| eKuiper 端口 | 仅开源 Neuron 需要:与 Neuron 同机部署的 eKuiper 的管理端口,默认 9081;NeuronEX 会自动发现内置 eKuiper,无需关心此项 |
分割线以下为 TDengine 写入信息:
| 配置项 | 说明 |
|---|---|
| TDengine 地址 | 当前集群 taosAdapter 的 REST 地址(默认端口 6041)。Neuron 网关必须能够访问该地址,请使用 Neuron 可达的主机名或 IP,不要直接使用回环地址 |
| 目标数据库 | 从当前集群中选择,数据库需提前创建。超级表和子表由无模式写入自动创建,请勿提前手工建表——手工建表的列类型若与写入数据不符,会导致写入失败 |
填写完成后,点击「下一步」。连接或校验失败会停留在本页并显示错误原因,请按提示修正后重试。
3. 确认映射
页面左侧列出每个采集组的设备数和目标超级表。超级表名默认与采集组同名,可逐个修改;同名采集组共用同一映射。多台 Neuron 写入同一数据库且设备重名时,在「子表名前缀」中为每个网关设置不同前缀。点击「预览映射」可在右侧核对各采集组的测量列和各设备写入的子表名(每组最多列出 10 台设备),也可以直接点击「下一步」。映射规则和命名要求见数据映射与采集配置规范。
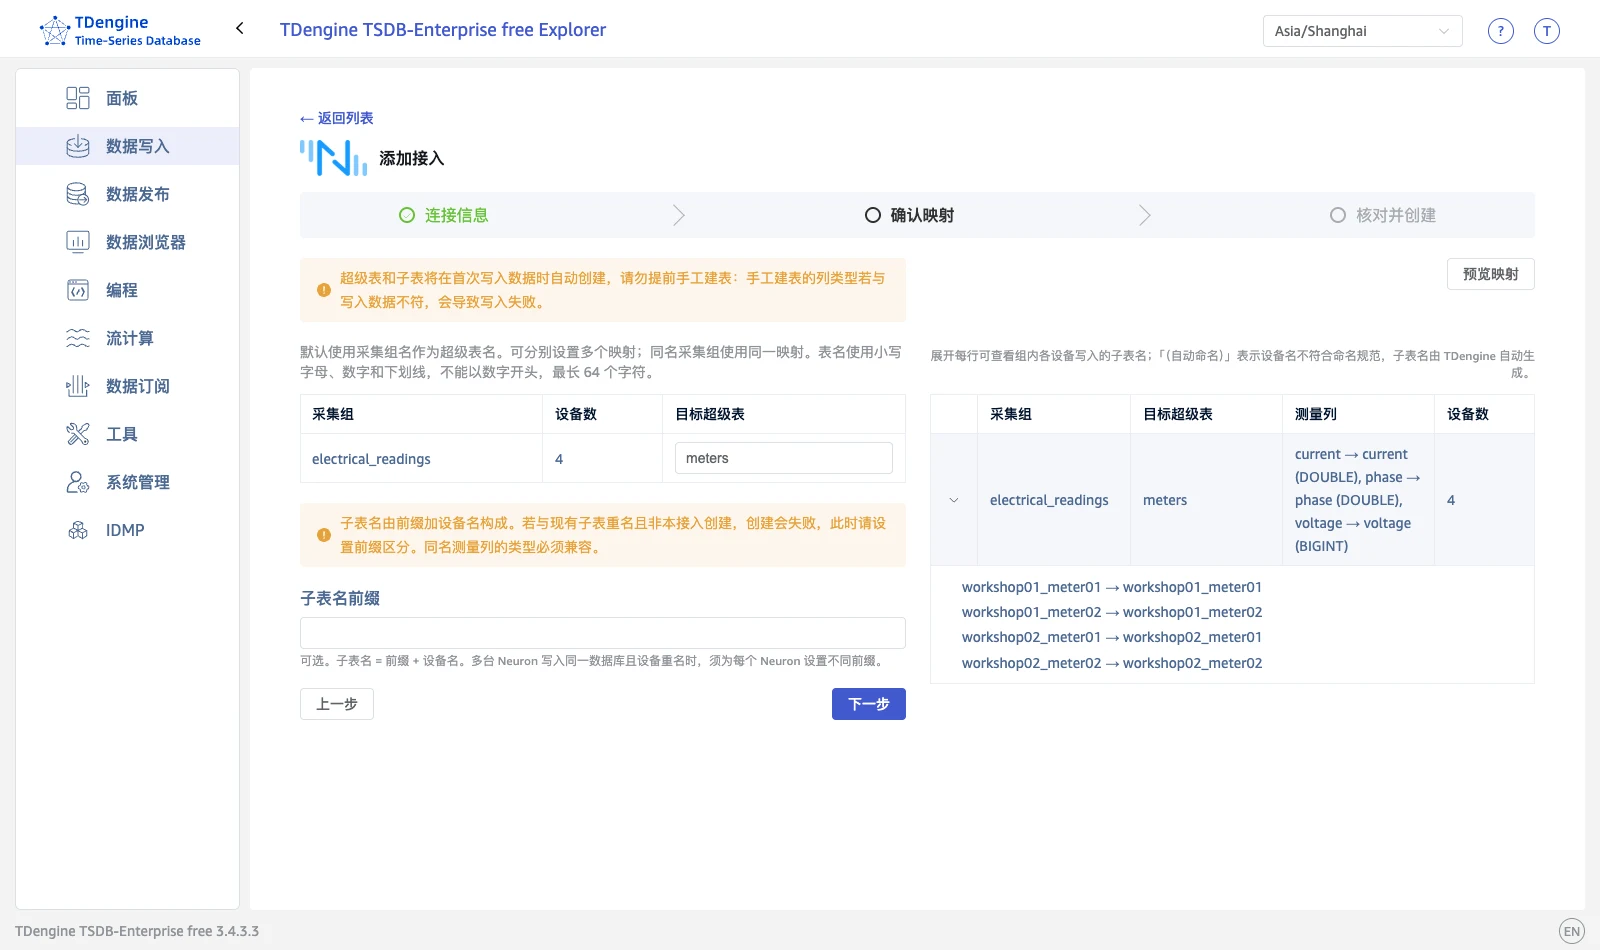
确认采集组映射与列映射
4. 核对并创建
确认页汇总将创建的配置:Neuron 地址、eKuiper 数据流、TDengine 地址、目标数据库、子表名规则、固定标签和写入账号。核对无误后点击「创建接入」。
taosExplorer 自动完成以下工作:
- 创建或复用共享的 eKuiper 数据流(全部 Neuron 接入共用一条流);
- 为每个采集组创建 InfluxDB v1 写入规则,启用 sink 缓存,按 1000 行或 100 ms 合批发送;
- 补充缺失的采集订阅(Neuron 北向订阅),已有订阅保持不变;
- 校验子表命名冲突,发现归属他方的同名子表时拒绝创建并给出提示。
已有的 eKuiper 配置不会被自动覆盖或删除。规则使用你当前登录的 TDengine 账号写入数据;修改该账号密码后,请在详情页点击「刷新配置」更新规则。
5. 查看状态与日志
创建完成后进入详情页:上方是接入信息、映射信息和监控信息,下方「执行日志」折叠面板展示最近 10 条配置与验收记录,最新记录在前。
状态变为「已验收」,表示规则运行正常、各子表持续出现新增数据。其他状态含义:「配置中/验收中」表示后台任务正在执行;「配置已保留,待验收」表示配置已下发但尚未观察到新数据;「执行失败/执行中断」可查看日志定位原因后重试。
详情页提供两个操作:
- 刷新配置:按原配置重新下发数据流和规则。修改 TDengine 密码、规则在 eKuiper 侧被改动或删除后,用它恢复。
- 检查数据:重新执行数据验收,检查各子表是否有新增数据。
配置完成后,数据由 Neuron 经 eKuiper 直接写入 TDengine,不依赖 taosExplorer 持续运行;关闭 taosExplorer 页面不影响数据采集。
手工接入
本节适用于已部署 Neuron 或 NeuronEX、需要自定义标签、业务属性或数据转换的场景。全新安装 NeuronEX 时,推荐使用前文的「安装时接入」。
本节以四台 Modbus TCP 智能电表为例,演示在 NeuronEX 页面手工完成接入的完整过程,供需要自定义标签、业务属性或数据转换的用户参考。电表只是示例,你的设备不是电表也能照做:只需把第 3 步换成你自己设备的采集配置(选择对应的协议插件、创建采集组、添加点位),其余步骤(创建数据库、数据流、处理规则、写入动作)与设备类型无关,操作完全相同。
示例数据模型
通用的对象映射、命名分组和类型映射见数据映射与采集配置规范;本节示例只展示一种具体配置。
示例在同一工厂的两个车间各部署两台电表,每秒采集电流、电压和相位。四台设备共用 meters 超级表,各写一个子表,采集组均命名为 electrical_readings。
设备名、子表名及 device 标签 | group_id | location |
|---|---|---|
workshop01_meter01 | 1 | Factory01.Workshop01 |
workshop01_meter02 | 1 | Factory01.Workshop01 |
workshop02_meter01 | 2 | Factory01.Workshop02 |
workshop02_meter02 | 2 | Factory01.Workshop02 |
TDengine 将 Factory01.Workshop01 保存为完整的 location 标签值;后续 IDMP 可按点号展开为 Factory01 → Workshop01。
业务字段参考 meters 建模示例。首次无模式写入自动建表,类型如下:
| 类别 | 字段 | 自动生成类型 |
|---|---|---|
| 时间列 | _ts | TIMESTAMP |
| 测量列 | current、phase | DOUBLE |
| 测量列 | voltage | BIGINT |
| 标签 | location、group_id、device | NCHAR |
实际字段类型由 Influx 行协议编码决定,与标准 meters 建模示例不完全相同;标签值仅含 ASCII 字符时,自动生成的类型仍为 NCHAR。
示例中的数据对应关系
在 NeuronEX 中,先添加电表设备并配置连接信息,再创建采集组、设置采集周期,最后添加电流、电压和相位等点位,为各点位指定寄存器地址和数据类型。采集数据与 TDengine 的对应关系如下:
| Neuron 数据 | TDengine 对象 | 配置方式 |
|---|---|---|
设备名 node_name | 子表名及 device TAG | 规则输出 device;sink 将其同时映射到 tbname 和 device 标签 |
采集组名 group_name | 用于筛选进入规则的报告 | SQL 筛选 electrical_readings 采集组;超级表名由 sink 的 measurement 独立指定 |
点位 values.current、values.voltage、values.phase | 测量列 current、voltage、phase | SQL 提取点位,sink 的 fields 指定写入列 |
报告时间戳 timestamp | 时间列 _ts | SQL 输出 ets,sink 设置 tsFieldName=ets、precision=ms |
| 位置及业务分组 | TAG location、group_id | SQL 根据设备名设置属性,sink 的 tags 指定标签 |
本例中,每台电表的一次完整采集报告写入其同名子表的一行,电流、电压和相位分别对应三个测量列。
Neuron Tag 是采集点位,对应测量列;TDengine TAG 是子表属性。group_id 是业务分组编号,与采集组名分开配置。group_name 也可映射为 TAG,但同一子表的组名应固定。
配置步骤
1. 创建数据库
在 TDengine SQL 客户端执行以下语句,无需手工创建超级表或子表:
CREATE DATABASE IF NOT EXISTS neuron_meters_demo PRECISION 'ms';
2. 检查直连接口
在 NeuronEX 所在主机或容器内执行以下命令,将 adapter-host 替换为实际 taosAdapter 主机名或 IP:
curl -i http://adapter-host:6041/influxdb/v1/ping
返回 204 No Content 表示接口可访问。InfluxDB v1 客户端启动时会调用该接口;若返回 404,检查路径及 TDengine 版本(3.4.3.6 及以上)。NeuronEX 可直接连接 taosAdapter,无需部署 nginx。如需加密传输或 taosAdapter 故障切换,参照加密传输与高可用一节配置 nginx。
3. 配置 Modbus 采集
-
进入「数据采集 → 南向设备」,按示例名称添加四台「Modbus TCP」设备,填写连接参数。
配置项 设置 说明 连接模式 客户端 主动连接电表 IP、端口 实际电表 IP、端口,通常为 502确定读取的设备 连接超时 3000ms限制无响应请求的等待时间 指令发送间隔 20ms同一连接相邻请求的间隔,与采集周期不同 32 位字节序 按设备手册设置,例如 ABCD正确解码浮点数 -
在每台设备下创建
electrical_readings采集组,周期设置为1000ms,添加以下三个读点。点位名称 类型 示例地址 占用寄存器 currentFLOAT1!400001400001、400002 voltageUINT161!400003400003 phaseFLOAT1!400004400004、400005 地址按设备寄存器表填写。
1!表示站号 1;FLOAT占两个寄存器,点位地址不可重叠。不同设备节点可使用相同的寄存器地址。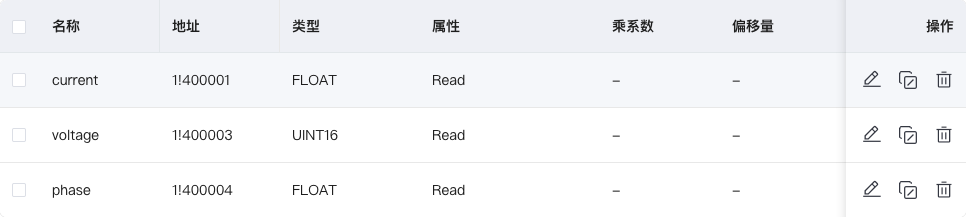
-
保存并启动设备,确认均为运行中、已连接。在「数据采集 → 数据监控」逐一选择设备及其采集组,检查三个点位数值正确并持续更新。
-
进入「数据采集 → 北向应用」,为内置
DataProcessing应用订阅四台设备的electrical_readings组,将报告送入 eKuiper。仅创建设备和规则不会自动建立此订阅。
4. 创建数据流
数据流定义采集报告的字段结构,后续规则从中读取数据。
-
进入「数据处理 → 源管理 → 创建」,填写以下配置。
配置项 设置 名称 meters_stream源类型 Neuron配置组 default数据格式 JSON带结构 开启 共享数据源 开启 -
添加下表中的字段。将
values设置为STRUCT,并在其下添加三个测量子字段。字段 类型 用途 timestampBIGINT报告时间戳,单位 ms node_nameSTRING设备名 group_nameSTRING采集组名 valuesSTRUCT测量值集合 values.currentFLOAT电流 values.voltageBIGINT整数电压 values.phaseFLOAT相位 -
保存数据流,确认结构包含全部待写入点位。
带结构定义可保留电压的整数类型,避免无结构 JSON 数值按浮点数处理。流中的 BIGINT 是 eKuiper 整数类型,与 Modbus 寄存器位宽无关。开启「共享数据源」后,多条规则可复用同一数据源。
5. 创建数据处理规则
-
进入「数据处理 → 规则 → 新建规则」,规则 ID 填写
meters_to_tdengine。 -
在 SQL 编辑区域输入以下语句。
SELECT values.current AS current,
       values.voltage AS voltage,
       values.phase AS phase,
       timestamp AS ets,
       node_name AS device,
       CASE WHEN node_name IN ("workshop01_meter01", "workshop01_meter02")
            THEN "1" ELSE "2" END AS group_id,
       CASE WHEN node_name IN ("workshop01_meter01", "workshop01_meter02")
            THEN "Factory01.Workshop01" ELSE "Factory01.Workshop02" END AS location
FROM meters_stream
WHERE group_name = "electrical_readings"
  AND node_name IN ("workshop01_meter01", "workshop01_meter02",
                    "workshop02_meter01", "workshop02_meter02")
该 SQL 筛选四台电表的
electrical_readings采集组报告,提取电流、电压和相位,保留原始时间戳和设备名,并按设备名设置位置与业务组编号。设备名用于指定子表名,位置与业务组编号写入 TAG。 -
点击「添加动作」,选择「InfluxDB v1」,按下一步配置写入动作。
四台设备共用一条规则。新增或替换同类设备时,更新北向应用订阅、SQL 中的设备范围及位置和业务组编号映射,无需逐台创建规则。
若采集报告包含位置和业务组编号等元数据,可在数据流中声明这些字段,再由 SQL 直接取值作为 TAG,减少按设备名逐一配置映射。本例通过 CASE 表达式设置这些属性。
6. 配置 InfluxDB v1 动作
以下 JSON 为 InfluxDB v1 动作的完整配置示例,与后续页面配置步骤对应。使用时替换地址、用户名和密码。
{
  "addr": "http://adapter-host:6041/influxdb/v1?table_name_key=tbname",
  "username": "<tdengine_username>",
  "password": "<tdengine_password>",
  "database": "neuron_meters_demo",
  "measurement": "meters",
  "precision": "ms",
  "tsFieldName": "ets",
  "fields": [
    "current",
    "voltage",
    "phase"
  ],
  "tags": {
    "tbname": "{{.device}}",
    "device": "{{.device}}",
    "group_id": "{{.group_id}}",
    "location": "{{.location}}"
  },
  "sendSingle": true,
  "batchSize": 1000,
  "lingerInterval": 100,
  "enableCache": true,
  "memoryCacheThreshold": 1024,
  "bufferPageSize": 256,
  "maxDiskCache": 102400,
  "resendInterval": 500
}
-
在「连接信息」中填写以下参数。将地址和账号替换为实际值。
配置项 设置 地址( addr)http://adapter-host:6041/influxdb/v1?table_name_key=tbname用户名( username)TDengine 专用写入账号 密码( password)上述账号的密码 数据库( database)neuron_meters_demo地址保留
/influxdb/v1路径;客户端自动追加/ping、/write并保留查询参数。用户名和密码使用独立字段。生产环境应使用专用写入账号,并限制配置文件、导出文件和管理 API 的访问权限。 -
在「数据处理」中配置字段及标签映射。
配置项 设置 时间精度( precision)msMeasurement( measurement)meters时间戳字段名( tsFieldName)etsFields( fields)current、voltage、phase标签 tbname{{.device}}标签 device{{.device}}标签 group_id{{.group_id}}标签 location{{.location}}table_name_key=tbname将tbname用于子表命名,不保存为 TAG;device保留设备身份。fields仅选择三个测量列,避免将ets等辅助字段作为测量列写入。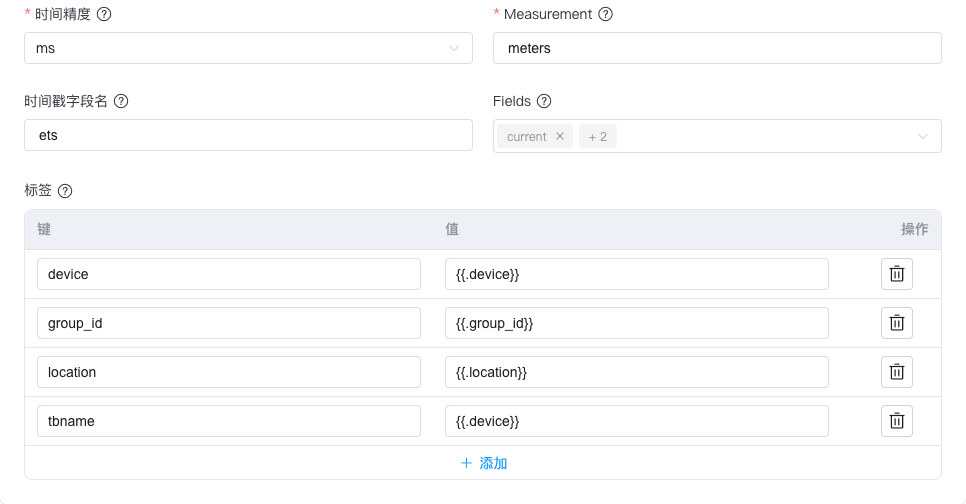
-
展开「Sink 配置」,将「启用缓存」(
enableCache)设为True,并按下表设置批量发送及缓存参数。配置项 设置 作用 批量发送大小( batchSize)1000达到批大小时发送 批量发送间隔( lingerInterval)100未满批时的等待时间,单位 ms 启用缓存( enableCache)True启用 sink 缓存 内存缓存阈值( memoryCacheThreshold)1024内存缓存消息阈值 缓冲区页面大小( bufferPageSize)256每磁盘页的消息数 最大磁盘缓存( maxDiskCache)102400磁盘缓存消息上限 重发间隔( resendInterval)500缓存重发间隔,单位 ms 达到
batchSize或等待满lingerInterval即触发发送,以先满足者为准;低流量时不必凑满 1000 行。缓存消息可能是一批数据,不能直接换算为入库行数或离线时长。参数含义以对应 eKuiper 版本说明为准。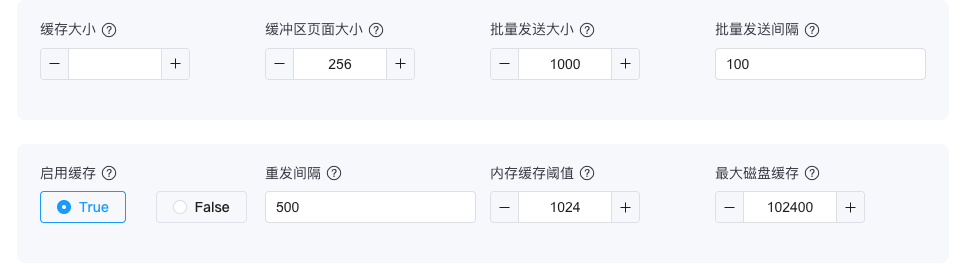
-
提交动作,保存并启动规则。
NeuronEX 页面默认设置 sendSingle=true,用于逐行计算动态标签,不表示逐行发起 HTTP 请求;通过规则 JSON 配置时须保留此参数。数据仍按上述参数批量发送,不同设备写入各自子表。实际延迟还包括排队和网络调用。
同一子表、同一毫秒的数据会被覆盖。使用全局唯一子表名,并保留报告时间戳;位置等属性变化时,显式更新子表 TAG。
验证结果
无论通过哪种方式接入,都以查询结果确认入库——规则运行状态和 ping 响应不能代替入库检查。以下 SQL 使用手工接入示例的库名和表名;安装时接入的用户把库名换成 neuron_demo(示例)或 neuron(真实设备)、超级表名换成采集组名;一键接入的用户把库名换成目标数据库、超级表名换成映射的超级表即可。
-
在 TDengine SQL 客户端检查自动生成的结构和设备标签。
DESCRIBE neuron_meters_demo.meters;

SELECT DISTINCT TBNAME, device, group_id, location
FROM neuron_meters_demo.meters;
应有四个子表,字段类型和标签与示例数据模型一致。
-
查询最新数据,与「数据采集 → 数据监控」比较。将子表名替换为其他设备名,逐一检查四台设备。
SELECT _ts, current, voltage, phase
FROM neuron_meters_demo.workshop01_meter01
ORDER BY _ts DESC LIMIT 5; -
间隔数秒重复执行以下查询,确认四个子表的行数持续增长。
SELECT TBNAME, COUNT(*)
FROM neuron_meters_demo.meters PARTITION BY TBNAME;
查看监控
在 taosExplorer 中查看规则运行指标,无需登录 NeuronEX。进入「数据写入 → 数据采集代理 → Neuron」,打开接入记录,在「监控信息」区域查看。页面打开时每 5 秒刷新一次,关闭页面后停止请求。
| 指标 | 正常状态或处理方式 |
|---|---|
| 规则状态 | 运行中;显示已停止时,检查 NeuronEX 是否重启、规则被手工停止,或试用版规则达到运行时限 |
| Sink 连接 | 已连接;断开时检查 NeuronEX 到 taosAdapter 的网络及 TDengine 服务 |
| 采集条数、发送批次 | 持续增加;发送批次是 eKuiper 的批次计数,不等于数据库行数 |
| 缓存 | 可短时波动,但应能回落;持续积压时参见缓存与转发 |
| 异常、最近异常 | 正常时为 0;非 0 时查看最近异常,并检查数据转换、账号或网络 |
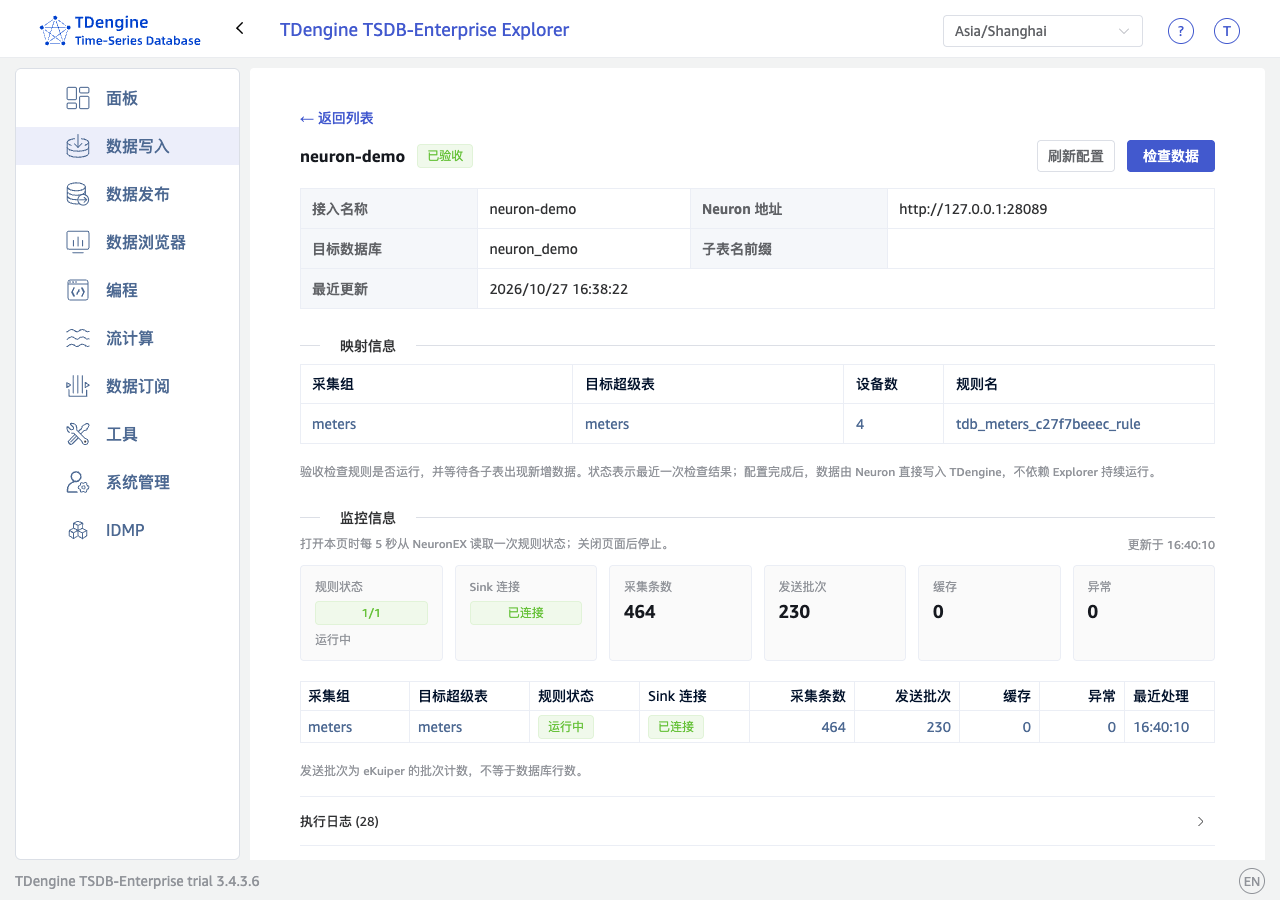
taosExplorer 中的 Neuron 监控信息
Sink 连接正常和规则运行中不能替代入库检查,仍应通过验证结果确认数据已写入 TDengine。如需查看各阶段明细,可在 NeuronEX 的「数据处理 → 规则」中点击「更多 → 数据统计」。
在 IDMP 中展示数据(可选)
在 IDMP「管理后台 → 连接」中配置 TDengine TSDB 连接,通过连接条目的「更多 → 简单导入」,选择 neuron_meters_demo.meters。
将 device 标签设为路径,路径开始层级填 0,表达式填 ${device};location 标签设为路径,路径开始层级填 1,表达式填 ${location};group_id 作为静态属性导入。location 按点号展开为工厂与车间层级,device(即子表名)作为叶子电表元素。
导入后,在「元素浏览器」中可查看以下层级,选择电表可查看 current、voltage、phase 测量属性:
Factory01
├── Workshop01
│   ├── workshop01_meter01
│   └── workshop01_meter02
└── Workshop02
    ├── workshop02_meter01
    └── workshop02_meter02
详细导入步骤参见 从 TDengine TSDB 构建数据模型。本例写入不携带单位信息,如需补充单位或配置换算,参见 计量单位。
缓存与转发(Store and Forward)
本方案由 eKuiper 的 InfluxDB v1 sink 提供缓存与转发。下游暂时不可用时,在容量允许且错误可重试的前提下缓存数据;连接恢复后,保留原有的子表名和报告时间戳重新发送。安装时接入和一键接入创建的规则已启用缓存(按 1000 行或 100 ms 合批),无需额外配置。
使用此功能须满足以下要求:
- eKuiper 须包含 Influx v1 错误重试修复 PR #4201,否则可能无法重发。部署前,向 EMQX 提供所用 NeuronEX 及内置 eKuiper 版本,确认已包含该修复。
- 手工接入时,在「数据处理 → 规则」中编辑对应规则的「InfluxDB v1」动作,展开「Sink 配置」,将「启用缓存」(
enableCache)设为True,并配置缓存容量和重发间隔。参数表及截图见配置 InfluxDB v1 动作。部署时持久挂载 eKuiper 数据目录。 - 监控磁盘空间、缓存长度和异常。持续积压时,调整采集周期、批量发送参数或采集组分配。
含该修复的构建已通过断链恢复验证,测试数据全部回补。账号、权限或模式错误也可能持续重试并阻塞后续数据,须人工修正;数据转换或构造 Influx 数据点时发生的错误,不一定触发重试。
进程崩溃或整机故障可能丢失内存及在途数据;缓存耗尽时也可能丢数据。
参数说明见 eKuiper sink 缓存与发送机制。
加密传输与高可用(可选)
需要 mTLS 或 taosAdapter 故障切换时,按 taosAdapter 高可用 部署 Nginx/HAProxy,并把 Neuron 的 sink 地址改为负载均衡地址。基础 HTTP 直连接入无需此配置;一键接入的用户把向导中的「TDengine 地址」填为负载均衡地址即可。
Neuron 侧配置
Neuron 写入使用 InfluxDB v1 路径。按 taosAdapter 高可用 中的 Nginx/HAProxy 配置、location /influxdb/v1/ 重试配置和健康检查部署负载均衡;TLS/mTLS 配置见同页的 TLS 与 mTLS 一节。示例仍使用 ingest.example.com:8443 作为负载均衡入口。
在规则的 InfluxDB v1 动作中,将地址改为 https://ingest.example.com:8443/influxdb/v1?table_name_key=tbname。在动作「连接信息」中上传客户端证书、私钥及服务端 CA 证书,将「跳过证书验证」设为 False。文件配置使用以下参数;证书路径须对 eKuiper 可读,容器部署时须挂载证书。
{
  "rootCaPath": "/etc/ekuiper/certs/server-ca.crt",
  "certificationPath": "/etc/ekuiper/certs/client.crt",
  "privateKeyPath": "/etc/ekuiper/certs/client.key",
  "insecureSkipVerify": false
}
保存动作并启动规则,按验证结果检查数据持续写入。生产环境关闭临时明文入口。
仅使用 HTTPS 服务端认证时,按 taosAdapter 高可用页的 TLS 与 mTLS 关闭客户端证书校验,eKuiper 侧保留 CA 校验。重试保留子表名、时间戳和测量值,利用同键写入处理重复;失败批次依赖 sink 缓存重发。通用的重试和 non_idempotent 语义见 健康检查与重试语义。
配置各层高可用
| 层次 | 部署要求 | 注意事项 |
|---|---|---|
| nginx | 双机 Keepalived VIP 或已有高可用负载均衡,sink 使用统一域名 | 同步配置及证书,域名与证书匹配 |
| taosAdapter | 三个节点各部署一个实例,连接同一 TDengine 集群 | 多个实例部署在同一主机不能覆盖主机故障 |
| TDengine | 按版本和许可配置集群、副本,参见 部署管理 | 示例的单机建库配置不提供数据库高可用 |
| NeuronEX | 按官方主备实践同步配置,正常仅由主机采集 | 切换期间可能暂停采集,Modbus 当前寄存器通常无法补读历史 |
| 边缘到中心网络 | 开启 sink 缓存并监控容量 | 恢复范围见缓存与转发 |
各组件的主备及集群切换须按实际部署拓扑验收。
性能参考
测试配置
以下为既有性能测试结果,供容量规划参考,覆盖开启缓存及 nginx mTLS 的正常连接场景。测试版本见下表,与前述直连功能验证环境不同。
| 项目 | 配置 |
|---|---|
| 硬件 | Intel Xeon E5-2696 v4,22 物理核、44 逻辑核,64 GiB 内存,NVMe |
| 部署 | Ubuntu 24.04,Linux x86_64,各组件同机原生进程 |
| Neuron | 开源 2.15.0,含 Modbus 事务序号回卷修复的自建版本 |
| eKuiper | 2.4.2+pr4201-perfcore 测试构建,含 Influx 错误分类修复 |
| TDengine | 企业版 3.4.3.6;ms、VGROUPS 16、WAL_LEVEL 1、WAL_FSYNC_PERIOD 3000 |
| 采集 | 16 个驱动 × 4 组 × 128 台逻辑电表 × 3 个测量值,共 24,576 配置点位;周期 100ms |
| 北向 | 8 个应用分别订阅不同的采集组,每应用 8 组,各自使用独立的数据源、规则和输出动作 |
| 批量发送与安全 | 批量发送间隔 100ms、batchSize=10000,每请求平均约 1024 行;缓存开启、bufferLength=20000、disableBufferFullDiscard=true、nginx mTLS、CA 校验 |
测试通过 Modbus 读取 Neuron 内置模拟器,各组复用寄存器。8,192 台逻辑电表不代表物理设备数量。每行含三个采集值,标签不计入点值吞吐。
参考结果
| 指标 | 实测结果 |
|---|---|
| 数据库行数净增 | 147,524,815 行 |
| 平均入库吞吐 | 81,913.81 行/秒 |
| 等价采集点值更新吞吐 | 245,741.42 个/秒 |
| 分段采样吞吐范围 | 80,359.68–83,470.95 行/秒 |
| 上报至成功响应 p99 | 1,171ms |
| 同口径最大延迟 | 2,054.33ms |
| sink 队列采样峰值 | 82 批,后续回落至零,最终队列为零 |
吞吐按数据库行数净增计算,每行三个采集值;点值吞吐不等于配置点位数。p99 从报告时间戳计至 taosAdapter 成功响应,按 1ms 精度统计,包含批量发送等待、排队和下游调用,不含 Modbus 采集时间。
停止采集并排空缓存后,规则有效输出行数、成功请求对应的行数、子表名与时间戳的唯一组合数及数据库行数一致。对账不含规则过滤的缺失值报告。
Neuron 与 eKuiper 平均各使用约 6.6 个逻辑核;Neuron 驻留内存约 73MiB,eKuiper 采样峰值约 275MiB,nginx 开销较小。未观察到驻留内存或 sink 队列持续增长。
结果供容量规划参考,不代表 TDengine 写入上限或官方发行包性能保证。部署时按实际设备、规则、字段数、网络及硬件复测并预留余量。扩大规模可按采集组分片部署多个 Neuron 与配套 eKuiper 实例,分配独立 CPU、使用唯一子表名;多实例扩展比例未经验证。
常见问题
| 现象 | 检查与处理 |
|---|---|
| 安装时接入后 taosExplorer 中没有接入记录 | 确认安装命令执行成功;同机安装检查本机 taosExplorer,跨机安装检查 --tdengine-host 对应的 taosExplorer,并查看安装输出和 taosExplorer 日志 |
| 安装时接入后状态一直是「配置已保留,待验收」 | 确认四个示例设备运行中、已连接;查看 NeuronEX「数据监控」是否有数据,并检查 taosExplorer 日志 |
| 忘记 NeuronEX 管理员密码 | 执行 sudo cat /var/lib/apex/neuronex-admin-password 查看安装时自动生成的密码 |
| 修改 NeuronEX 密码后数据停止写入 | 重新执行安装命令并通过 --neuron-password-file 传入新密码,更新 taosExplorer 中的凭据 |
| 一键接入提示「没有找到含可读点位的采集组」 | 先在 Neuron 完成设备采集配置,确认设备运行中、已连接,且「数据监控」中有点位值 |
| 一键接入创建失败,提示子表重名或冲突 | 子表名与库中现有表冲突,为接入设置「子表名前缀」区分;同时确认同名测量列类型兼容 |
| 修改 TDengine 密码后数据停止写入 | 在接入详情页点击「刷新配置」,用当前登录凭据更新规则 |
| 详情页状态为「配置已保留,待验收」 | 确认 Neuron 正在采集、规则在 eKuiper 中运行,然后点击「检查数据」重新验收 |
| 删除设备或采集组后同步失败 | 当前版本不会自动清理旧规则;在 eKuiper 中删除对应规则后,再点击「刷新配置」重试 |
| 采集数值异常 | 检查站号、寄存器地址、字节序及浮点地址是否重叠 |
| 规则启动后自动停止 | 检查许可是否包含数据处理功能;仅测试使用的规则可能运行 60 分钟后自动停止 |
| HTTPS 连接失败 | 检查 CA、服务端 SAN、客户端证书及容器内证书路径 |
| taosExplorer 详情页中的缓存长度持续增长 | 调整采集周期、批量发送参数或采集组分配,避免长期发送慢于采集 |
| 缓存开启后仍无法重发 | 按缓存与转发确认版本已包含重试修复,并检查错误分类、磁盘空间及缓存容量 |
附录:数据映射与采集配置规范
接入前,先了解 Neuron 中的对象如何对应到 TDengine,以及什么样的采集配置能顺畅接入。
使用「安装时接入」时,对象映射和表结构由安装器自动完成,可跳过对象映射部分;但设备命名与分组规范对三种方式都适用,建议在 NeuronEX 配置设备前阅读。
对象映射
| Neuron 对象 | TDengine 对象 | 说明 |
|---|---|---|
设备(南向节点)node_name | 子表 | 每台设备一张子表,子表携带 device 标签记录设备名 |
采集组 group_name | 超级表 | 一个采集组对应一张超级表,组内设备共用表结构 |
点位 values.* | 测量列 | 每个点位对应一个测量列 |
报告时间戳 timestamp | 时间列 _ts | 毫秒精度 |
安装时接入和一键接入按上表自动完成映射,并额外附加固定标签:device(设备名)、group_name(采集组名)、protocol(设备所用插件协议)和 gateway(Neuron 网关地址,用于区分多个网关写入同一数据库);子表名默认为「前缀 + 设备名」,设备名无法原样写入或同一设备属于多个采集组时,由 TDengine 按标签集合自动命名。手工接入可自行定义标签与子表命名。位置、单位、业务层级等属性不属于采集配置,安装时接入和一键接入不会自动推断,需要时请使用手工接入自行定义。
命名与分组规范
以下规范针对 Neuron 侧的采集配置本身,与接入方式无关。遵循这些规范,接入得到的表结构最清晰、可读性最好:
- 设备名全局唯一。同名设备会写入同一子表,造成数据混写。同一 Neuron 实例内设备名天然唯一;多台 Neuron 网关写入同一数据库时,设备名可能重复,此时应为每个网关设置不同的子表名前缀。
- 设备名使用规范字符。字母、数字、下划线、连字符、中文均可,数字开头也没有问题;避免点号
.、引号、反斜杠和控制字符,否则设备名无法直接用作子表名,只能改用自动生成的名称,排查时不直观。 - 一个设备只放入一个采集组。TDengine 库内子表名全局唯一、不按超级表隔离,跨组设备无法在各组复用设备名作为子表名。
- 同一采集组内设备结构一致。采集组对应超级表,组内设备的点位名称和类型应当相同,否则同名列出现类型冲突;结构不同的设备请分到不同采集组。
- 组名使用合法标识符。小写字母、数字、下划线,不以数字开头,最长 64 字符的组名可直接用作超级表名。
- 点位名使用规范字符。点位名转为列名时会做归一化(转小写、特殊字符转为下划线、数字开头自动加前缀);
ts、_ts、ets、device、group_name等保留名会被自动改名;含反引号、反斜杠的点位名无法转为列名。
类型映射
点位的 Neuron 类型按下表映射为 TDengine 列类型。安装时接入和一键接入自动按下表执行,首次写入时自动建表;手工接入可参照此表自行编写规则:
| Neuron 点位类型 | TDengine 列类型 | 说明 |
|---|---|---|
INT8/INT16/INT32/INT64、UINT8/UINT16/UINT32、BIT、WORD/DWORD/LWORD | BIGINT | |
UINT64 | BIGINT | 超出有符号 64 位范围的值会被截断(已知限制) |
FLOAT、DOUBLE | DOUBLE | |
BOOL | BOOL | |
STRING | NCHAR | |
BYTES | NCHAR | 按 base64 文本写入 |
ARRAY_* | NCHAR | 按 JSON 数组文本写入 |
| 带标度(scale)的整数点位 | DOUBLE | 按标度换算为浮点值 |