边缘网关接入
概述
边缘网关接入面向已在 Neuron / NeuronEX 网关上完成设备采集配置的场景:在 TDengine Explorer 的「数据写入 → 边缘网关」页签中填写网关地址和凭据、确认映射后,Explorer 自动完成数据流、写入规则和采集订阅的配置,采集数据随即持续写入当前集群。
与本章其他接入方式不同,边缘网关接入不创建 taosX 接入任务,也无需配置解析与映射规则——设备、点位、数据类型的定义直接取自网关侧已有的采集配置。数据面为 Neuron → eKuiper → taosAdapter,通过无模式写入自动创建超级表和子表;配置完成后数据链路不依赖 Explorer 持续运行。
目前支持 NeuronEX 及开源 Neuron + eKuiper 组合。
前置条件
- 已部署 Neuron 和 eKuiper:可以是 NeuronEX 4.0.0 及以上版本(已集成两者,参见 NeuronEX 安装文档),也可以是开源组合的 Neuron 2.15.0 及以上版本与 eKuiper(须包含 InfluxDB v1 sink)。
- 已在 Neuron(或 NeuronEX)中完成设备采集配置:设备已添加、采集组已创建、点位已配置,设备处于运行中、已连接状态,且在「数据监控」中能看到点位值持续更新。设备使用的协议没有限制——Modbus、OPC UA、Siemens S7 等 Neuron 支持的协议均可。
- Neuron 所在主机能够访问 taosAdapter 的 HTTP 端口,默认为
6041。 - 需要断链缓存与恢复补发时,需确认 eKuiper 已包含缓存与转发一节所述的错误重试修复。
- 已部署 TDengine TSDB 3.4.3.6 及以上版本,并已创建用于写入的数据库。
数据映射与采集配置规范
接入前,先了解 Neuron 中的对象如何对应到 TDengine,以及什么样的采集配置能顺畅接入。
对象映射
| Neuron 对象 | TDengine 对象 | 说明 |
|---|---|---|
设备(南向节点)node_name | 子表 | 每台设备一张子表,子表携带 device 标签记录设备名 |
采集组 group_name | 超级表 | 一个采集组对应一张超级表,组内设备共用表结构 |
点位 values.* | 测量列 | 每个点位对应一个测量列 |
报告时间戳 timestamp | 时间列 _ts | 毫秒精度 |
一键接入按上表自动完成映射,并额外附加固定标签:device(设备名)、group_name(采集组名)、protocol(设备所用插件协议)和 gateway(Neuron 网关地址,用于区分多个网关写入同一数据库);子表名默认为「前缀 + 设备名」,设备名无法原样写入或同一设备属于多个采集组时,由 TDengine 按标签集合自动命名。手工接入可自行定义标签与子表命名。位置、单位、业务层级等属性不属于采集配置,一键接入不会自动推断,需要时请使用手工接入自行定义。
命名与分组规范
以下规范针对 Neuron 侧的采集配置本身,与接入方式无关。遵循这些规范,接入得到的表结构最清晰、可读性最好:
- 设备名全局唯一。同名设备会写入同一子表,造成数据混写。同一 Neuron 实例内设备名天然唯一;多台 Neuron 网关写入同一数据库时,设备名可能重复,此时应为每个网关设置不同的子表名前缀。
- 设备名使用规范字符。字母、数字、下划线、连字符、中文均可,数字开头也没有问题;避免点号
.、引号、反斜杠和控制字符,否则设备名无法直接用作子表名,只能改用自动生成的名称,排查时不直观。 - 一个设备只放入一个采集组。TDengine 库内子表名全局唯一、不按超级表隔离,跨组设备无法在各组复用设备名作为子表名。
- 同一采集组内设备结构一致。采集组对应超级表,组内设备的点位名称和类型应当相同,否则同名列出现类型冲突;结构不同的设备请分到不同采集组。
- 组名使用合法标识符。小写字母、数字、下划线,不以数字开头,最长 64 字符的组名可直接用作超级表名。
- 点位名使用规范字符。点位名转为列名时会做归一化(转小写、特殊字符转为下划线、数字开头自动加前缀);
ts、_ts、ets、device、group_name等保留名会被自动改名;含反引号、反斜杠的点位名无法转为列名。
类型映射
点位的 Neuron 类型按下表映射为 TDengine 列类型。一键接入自动按下表执行,首次写入时自动建表;手工接入可参照此表自行编写规则:
| Neuron 点位类型 | TDengine 列类型 | 说明 |
|---|---|---|
INT8/INT16/INT32/INT64、UINT8/UINT16/UINT32、BIT、WORD/DWORD/LWORD | BIGINT | |
UINT64 | BIGINT | 超出有符号 64 位范围的值会被截断(已知限制) |
FLOAT、DOUBLE | DOUBLE | |
BOOL | BOOL | |
STRING | NCHAR | |
BYTES | NCHAR | 按 base64 文本写入 |
ARRAY_* | NCHAR | 按 JSON 数组文本写入 |
| 带标度(scale)的整数点位 | DOUBLE | 按标度换算为浮点值 |
一键接入
一键接入在 TDengine Explorer 中完成,无需在 NeuronEX 或 eKuiper 中做任何手工配置。
1. 打开接入向导
登录 TDengine Explorer,在左侧导航选择「数据写入」,切换到「边缘网关」页签,点击 Neuron 卡片。
2. 填写连接信息
上半部分为 Neuron 连接信息:
| 配置项 | 说明 |
|---|---|
| 接入名称 | 可选,用于列表与详情展示;留空时使用 Neuron 地址 |
| Neuron 地址 | Neuron 管理接口地址,如 http://neuron-host:7000 |
| Neuron 用户名、密码 | Neuron 的登录凭据 |
| eKuiper 端口 | 仅开源 Neuron 需要:与 Neuron 同机部署的 eKuiper 的管理端口,默认 9081;NeuronEX 会自动发现内置 eKuiper,无需关心此项 |
分割线以下为 TDengine 写入信息:
| 配置项 | 说明 |
|---|---|
| TDengine 地址 | 当前集群 taosAdapter 的 REST 地址(默认端口 6041)。Neuron 网关必须能够访问该地址,请使用 Neuron 可达的主机名或 IP,不要直接使用回环地址 |
| 目标数据库 | 从当前集群中选择,数据库需提前创建。超级表和子表由无模式写入自动创建,请勿提前手工建表——手工建表的列类型若与写入数据不符,会导致写入失败 |
填写完成后,点击「下一步」。连接或校验失败会停留在本页并显示错误原因,请按提示修正后重试。
3. 确认映射
页面左侧列出每个采集组的设备数和目标超级表。超级表名默认与采集组同名,可逐个修改;同名采集组共用同一映射。多台 Neuron 写入同一数据库且设备重名时,在「子表名前缀」中为每个网关设置不同前缀。点击「预览映射」可在右侧核对各采集组的测量列和各设备写入的子表名(每组最多列出 10 台设备),也可以直接点击「下一步」。
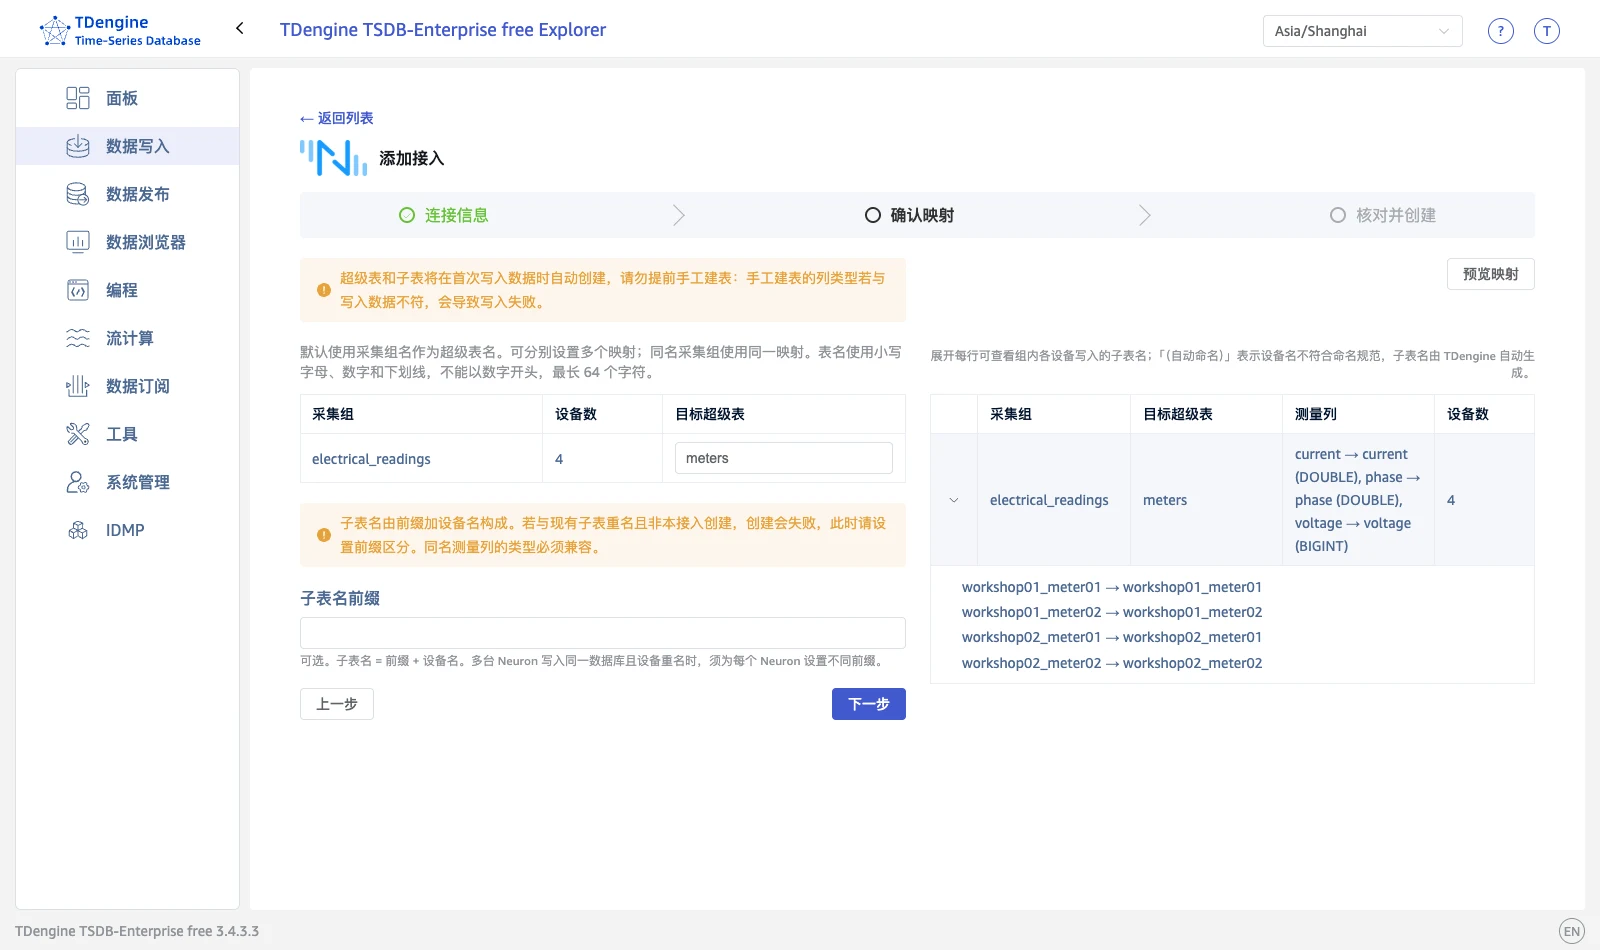
确认采集组映射与列映射
4. 核对并创建
确认页汇总将创建的配置:Neuron 地址、eKuiper 数据流、TDengine 地址、目标数据库、子表名规则、固定标签和写入账号。核对无误后点击「创建接入」。
Explorer 自动完成以下工作:
- 创建或复用共享的 eKuiper 数据流(全部 Neuron 接入共用一条流);
- 为每个采集组创建 InfluxDB v1 写入规则,启用 sink 缓存,按 1000 行或 100 ms 合批发送;
- 补充缺失的采集订阅(Neuron 北向订阅),已有订阅保持不变;
- 校验子表命名冲突,发现归属他方的同名子表时拒绝创建并给出提示。
已有的 eKuiper 配置不会被自动覆盖或删除。规则使用你当前登录的 TDengine 账号写入数据;修改该账号密码后,请在详情页点击「刷新配置」更新规则。
5. 查看状态与日志
创建完成后进入详情页:上方是接入配置和映射关系,下方「执行日志」折叠面板展示最近 10 条配置与验收记录,最新记录在前。
状态变为「已验收」,表示规则运行正常、各子表持续出现新增数据。其他状态含义:「配置中/验收中」表示后台任务正在执行;「配置已保留,待验收」表示配置已下发但尚未观察到新数据;「执行失败/执行中断」可查看日志定位原因后重试。
详情页提供两个操作:
- 刷新配置:按原配置重新下发数据流和规则。修改 TDengine 密码、规则在 eKuiper 侧被改动或删除后,用它恢复。
- 检查数据:重新执行数据验收,检查各子表是否有新增数据。
配置完成后,数据由 Neuron 经 eKuiper 直接写入 TDengine,不依赖 Explorer 持续运行;关闭 Explorer 页面不影响数据采集。
更多说明
- 需要自定义标签、业务属性或数据转换时,使用 Neuron 手工接入。
- 入库验证 SQL、运行监控、断链缓存(Store-and-Forward)、mTLS 与高可用部署、性能参考及常见问题,见 Neuron 集成。